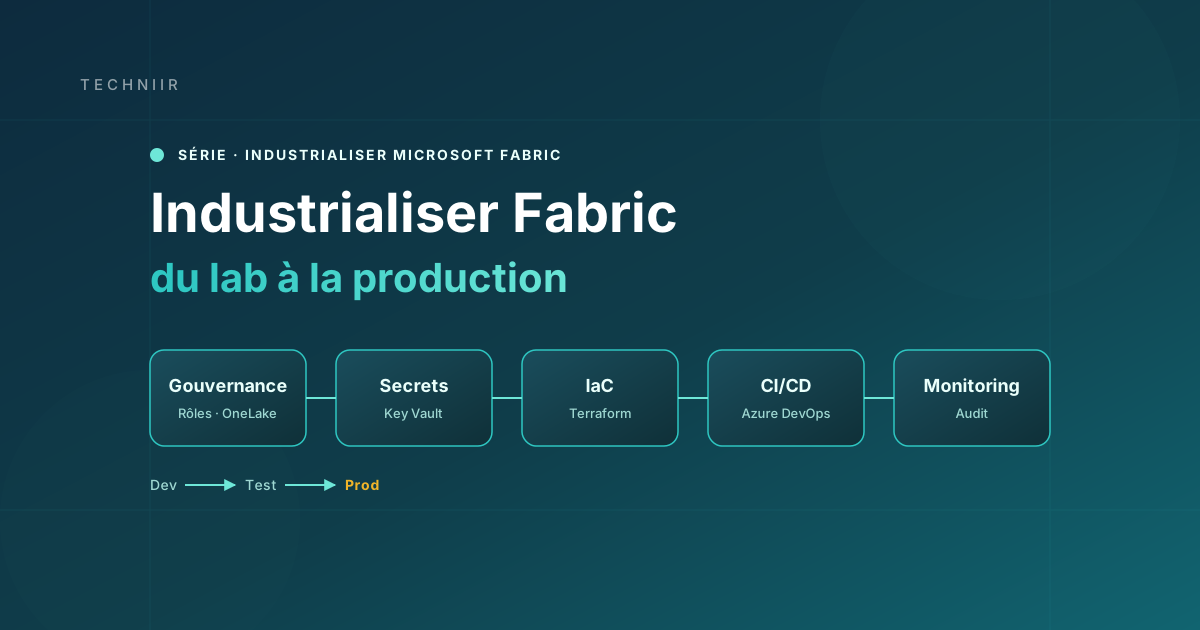
Activer Git integration sur un workspace ne suffit pas à rendre Fabric prêt pour la production. Il faut cinq piliers. Pour chacun : le point essentiel, et l’article de la série qui le détaille.
Vérifié en lab en octobre 2026 : rôles OneLake sur lh_dp700_sandbox, et lecture d’un secret depuis un notebook Fabric dans un coffre kv-techniir-lab-manuel en mode RBAC.
1. Gouvernance : qui voit quoi
Deux couches d’accès coexistent : les rôles de workspace (Admin, Member, Contributor, Viewer) et les rôles OneLake security (dossiers et tables d’un lakehouse).
Le point à retenir : les rôles OneLake ne filtrent que les Viewers. Un Contributor voit toutes les données, quels que soient les rôles OneLake. Et un membre d’un rôle OneLake sans rôle de workspace reçoit un 401 : il n’entre même pas.
Règle simple : Admin, Member et Contributor pour ceux qui construisent ; Viewer plus un rôle OneLake ciblé pour ceux qui lisent.
À lire : Rôles OneLake : ils s’additionnent, DefaultReader compris et le point de terminaison SQL.
2. Secrets : jamais dans le code
Un identifiant ou un mot de passe ne s’écrit jamais dans un notebook, même “pour tester”. Il se range dans Azure Key Vault et se lit au moment de l’exécution :
secret = notebookutils.credentials.getSecret("https://<mon-vault>.vault.azure.net/", "<nom-du-secret>")Attention à l’identité : le secret est lu avec l’identité qui exécute le notebook. Celle-ci doit avoir le rôle Key Vault Secrets User sur le coffre, sinon l’appel échoue.
Autre piège, vérifié en lab : dans un Key Vault en mode RBAC, avoir créé le coffre ne donne aucun droit sur les secrets (sauf rôle Key Vault déjà hérité, par exemple Key Vault Administrator sur l’abonnement). La création du premier secret échoue en Forbidden (« L’opération n’est pas autorisée par RBAC »). Il faut s’attribuer le rôle Key Vault Secrets Officer pour créer un secret ; Secrets User ne permet que de le lire.
3. Infrastructure as code : rien au clic
Les ressources Azure (Key Vault, groupes de ressources, rôles) se décrivent dans du code, par exemple Terraform, et se déploient par un pipeline. Un même code sert à tous les environnements ; seules les valeurs changent (nom du vault de dev, de test, de prod).
4. CI/CD : un environnement après l’autre
Le contenu Fabric passe de Dev à Test puis à Prod, piloté par Azure DevOps avec un service principal plutôt qu’un compte personnel.
Le point à retenir : un déploiement Fabric déplace les définitions des items (notebooks, rapports, modèles). Il ne déplace ni les données, ni les connexions, ni les planifications. Ce qui ne bouge pas doit être prévu à part.
À lire : Git integration Fabric : les 5 actions Source Control et Déployer Fabric via Azure DevOps et Service Principal.
5. Monitoring : savoir ce qui tourne
Industrialiser, c’est aussi observer. Côté Warehouse, deux outils répondent à deux questions différentes : les DMV montrent ce qui tourne en ce moment, Query Insights montre ce qui a tourné.
À lire : Les DMV de Fabric Warehouse et Query Insights dans Fabric Warehouse.
Checklist
- Consommateurs de données en Viewer, avec un rôle OneLake ciblé
- Aucun secret dans le code : tout dans Key Vault
- L’identité qui exécute les pipelines a accès au Key Vault
- Infrastructure décrite en code, jamais créée au clic
- Déploiements Dev → Test → Prod par service principal
- Connexions et planifications prévues à part dans chaque environnement
- Un moyen de voir ce qui tourne, et ce qui a tourné
Pour aller plus loin, consultez la série Industrialiser Microsoft Fabric ou contactez-nous.